Pangram: детектор ИИ-текста ловит нейросети в словах, но бессилен перед картинками
Источник фото: Press service
Pangram с лёгкостью уличает чат-ботов в сочинении абзацев, но при виде сгенерированной картинки беспомощно разводит руками. Прогресс, ничего не скажешь.
Pangram — сервис, который анализирует текст и выносит вердикт: написан человеком или сгенерирован языковой моделью. На англоязычных материалах инструмент демонстрирует высокую точность, уверенно отделяя живой абзац от гладкого, но безжизненного потока слов типичного чат-бота. Он не понимает смысла и не проверяет фактов — он изучает ритм фраз, длину предложений, частотность слов и характерные для моделей статистические закономерности. Именно стиль, а не содержание, выдаёт машину.
Такой детектор превращается в практический инструмент для редакций, преподавателей, приёмных комиссий и модераторов, которым приходится разгребать растущие горы однотипных текстов. Возможность быстро отсеять машинную генерацию воспринимается как возвращение контроля над собственным вниманием и рабочим временем. Чувство понятное: несколько лет автоматический текст заполнял ленты, письма и заявки, а противодействие выглядело безнадёжным.
Однако с текстами всё относительно благополучно по сравнению с изображениями, и здесь начинаются сложности. Детекторы текста опираются на статистику и потому ошибаются на людях, чей стиль выбивается из усреднённой нормы. Фиксировались ложные срабатывания на работах тех, для кого английский не родной: аккуратные, шаблонные по структуре эссе легко принимались за машинные. Разработчик одной из крупнейших языковых моделей в своё время свернул собственный классификатор, признав его ненадёжность. Обвинение в машинном авторстве способно стоить студенту диплома, а специалисту репутации, поэтому процент уверенности детектора не равен доказательству.
С изображениями ситуация ещё туманнее. Надёжных визуальных детекторов, которые по одному взгляду отличают сгенерированную картинку от фотографии, практически нет. Работающие подходы опираются не на разглядывание пикселей, а на криптографические метаданные и водяные знаки, встраиваемые в момент генерации. Такие следы исчезают при пересохранении, кадрировании или обычном скриншоте, а значит, исчезает и вся доказательная база. Инструмент, заточенный под слова, в этом сюжете оказывается бесполезен.
Отсюда практический вывод: детектор стоит воспринимать как повод для разговора, а не как приговор. Его сигнал полезен внутри редакции, школы или сообщества, где заранее согласованы правила и известны последствия. Как аргумент в споре с незнакомцем он почти бессилен.
Наблюдение первое: ценность подобных сервисов растёт не от точности процентов, а от прозрачности происхождения контента. Метаданные о том, где и чем создан файл, надёжнее любых догадок о стиле, но фиксировать их нужно на входе, а не восстанавливать задним числом.
Наблюдение второе: сам факт существования детектора меняет поведение. Люди начинают писать конкретнее, убирать шаблонные обороты и рубленые перечисления, чтобы их не приняли за машину. Это неожиданный побочный эффект: инструмент охоты за нейросетями постепенно учит людей писать лучше.
Читайте также на наших страницах:
 Аксессуары USB-C для ноутбука: что действительно нужно, а что маркетинг Ноутбук с USB-C обещает один кабель для всего, но рынок аксессуаров превращает это в культ донглов. На деле большинство из них можно заменить двумя правильными вещами. Технологии 99
 Лучшая беспроводная мышь: платите за форму и кнопки, а не за тысячи DPI Производители обещают революцию, но решают всё геометрия корпуса, ресурс переключателей и батарея. Цифры на коробке к правде отношения не имеют. Технологии 1 232
 Bluetooth-приёмники и передатчики: как оживить старую акустику и подключить любые наушники к телевизору Колонки за сто тысяч и телевизор с приличным звуком способен обесценить один отсутствующий чип ценой в чашку кофе — но это лечится коробочкой размером со спичечный коробок Технологии 1 293
 Google Pixel 11: обзор флагмана, перегруженного ИИ-функциями Google снова продаёт телефон как витрину для нейросети: Gemini умеет почти всё, кроме ответа на вопрос, зачем это обычному человеку. Технологии 1 274
 Складной iPhone Duo за 1999 долларов: Apple продаёт нишевый формат как премиум Складные смартфоны не стали массовыми, но Apple выводит iPhone Duo за 1999 долларов в октябре. Логика знакомая: если спроса мало, его можно заменить высокой ценой. Технологии 1 265
 Московский центр диагностики и телемедицины: ИИ-ассистенты, единый цифровой архив снимков и другой формат работы радиолога Москва перевела лучевую диагностику в цифровой контур: снимки попадают в общее хранилище, а нейросети подсказывают радиологам, куда смотреть. Забавнее всего, что алгоритм может найти патологию, но ответственность за заключение всегда остаётся человеку. Технологии 7 137
 Международная неделя видеоигр в Сколково: индустрия ищет новый уровень Западные платформы сворачиваются, а российская игровая индустрия собирается в Сколково, чтобы доказать: игры — не просто развлечение, а стратегический сектор экономики. Разработчики, инвесторы и энтузиасты обсуждают экспорт, технологии и будущее без привычных магазинов приложений. Технологии 7 906
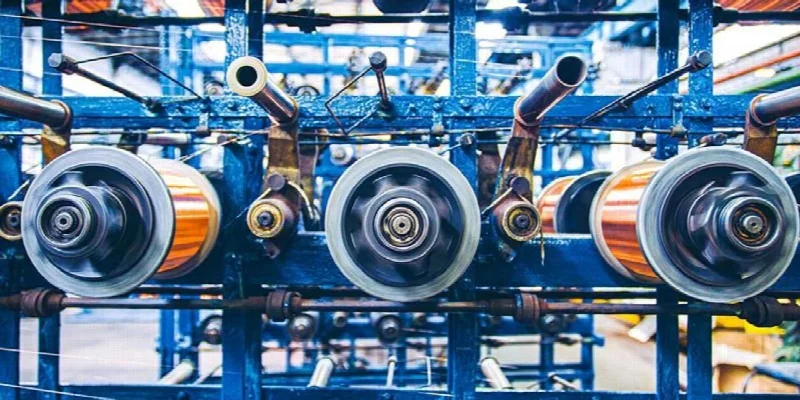 Промышленность Москвы выросла на 12,1% за полугодие благодаря высокотехнологичным отраслям Промышленный рост в Москве составил 12,1% за шесть месяцев. Обрабатывающие отрасли - 12,5%. Производство кабельных изделий увеличилось в 3,3 раза, электроники и оптики - на 39,1%, фармсубстанций - на 29,4%. Ставка на высокотехнологичные производства обеспечивает технологический суверенитет и рабочие места. Новости 9 812
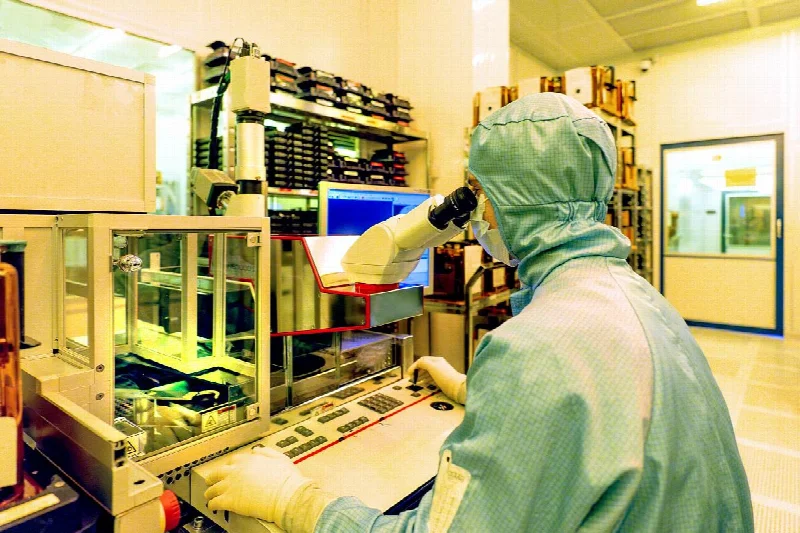 «Микрон» — крупнейший производитель и экспортер микроэлектроники России в ОЭЗ «Технополис Москва» «Микрон» — крупнейший производитель и экспортер микроэлектроники, резидент ОЭЗ «Технополис Москва». Ирония: стратегическому заводу для выживания нужен налоговый оазис, а не громкие обещания. Технологии 11 301
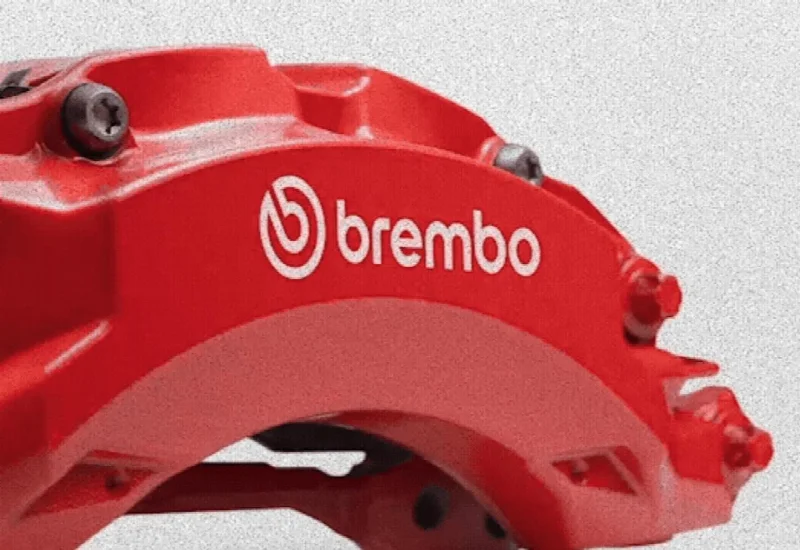 Brembo Boldika — самый мощный суппорт для тяжёлых электропикапов и внедорожников Самый мощный суппорт Brembo — не для суперкаров, а для четырёхтонных электропикапов. Алюминий не справился, и в конструкцию вернули чугун. Мода на сверхлёгкость проигрывает весу батарей. Авто 11 375
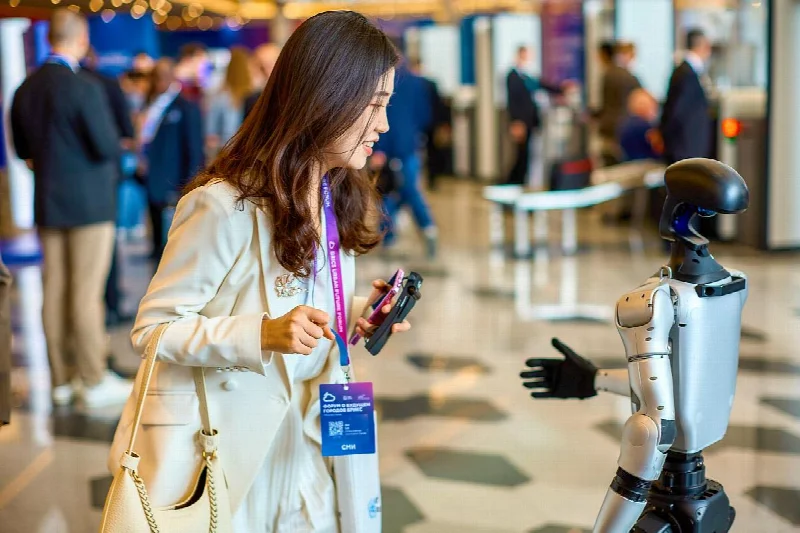 История: Москва собирает экспертов БРИКС: роботы и ИИ определят города 2040 года Москва принила третий форум «Облачные города»: 320 экспертов из стран БРИКС решают, как ИИ и роботы изменят города до 2040 года. Устойчивое развитие обещано, а вот живые города пусть подождут. Технологии 11 262
 К Альфе Центавра за 80 000 лет: первый межзвёздный зонд от создателей Starcloud Создатели Starcloud, не успев запустить дата-центры на орбиту, целятся в Альфу Центавра. Крошечный зонд за 15 миллионов долларов будет лететь 80 тысяч лет. Главное — чтобы инвесторы не передумали. Технологии 12 888
 Год в воздухе без топлива: индийский стартап строит беспилотник на энергии океанского ветра Индийский стартап Alteon хочет держать беспилотник в воздухе больше года, питаясь энергией океанского ветра. Lachy Groom поверил за полчаса и вложил 2,5 млн долларов. Пока только тесты. Технологии 14 184
 Magna увеличивает ставку на замену батарей в Индии: ещё $35 млн в Yuma Пока скептики хоронят замену аккумуляторов, Magna докладывает $35 млн в Yuma. Логика проста: 90% курьеров ездят на бензине, а время — деньги. Кто успеет подставить батарею — тот и выиграет. Технологии 15 911
 Литейня Маска для газовых турбин: чем ИИ заплатит за ускорение Илон Маск сам займётся литьём лопаток для газовых турбин — ведь ИИ без смога не работает. Ускорение на 18 месяцев, четыре монополиста больше не нужны, а жители Мемфиса могут дышать глубже. Прогресс! Технологии 17 128
 Испанский микрокар Liux Big: экологичная ставка против китайских конкурентов Испанский микрокар Big против китайских машин: лён, переработка, зарядка от солнца. «Европейского автомобиля не существует», — признаёт стартап. Big — сарказм: маленькая машина, большие амбиции. Технологии 18 490
 Китайские роботы и дроны: масштаб сильнее барьеров США Китай занимает 86% мировых поставок гуманоидных роботов, предлагает низкую стоимость и глубокую производственную цепочку, расширяется на рынки Европы, Азии и Латинской Америки, сохраняя лидерство даже при ограничениях США. Технологии 18 479
 Код — это речь: почему исходники защищены Первой поправкой Программный код — это высказывание, даже если он не похож на стихи. Суды уже назвали его речью. От шифрования до ИИ — вопрос о пределах этой свободы становится главным юридическим спором десятилетия. Технологии 19 915
 Лоу-фай против алгоритма: как разорвать зависимость от смартфона Думаете, нужны курсы осознанности? Нет: достаточно купить плеер за пятьсот рублей и забыть про рекомендации. Ирония: самый верный способ перехитрить алгоритм — стать для него невидимым. Технологии 19 885
 SpaceX: лучшая и худшая инвестиция одновременно — всё решает цена входа SpaceX — лучшая инвестиция в мире, если вы успели купить её десять лет назад. Для тех, кто зайдёт через IPO, это столь же бесспорный мусор. Разница — в цене и количестве иллюзий, которые покупатели готовы оплатить. Технологии 20 115